Un flujo de trabajo bayesiano en R para la agregación electoral e incertidumbre provincial
José Luis Cañadas Reche
2026-01-01
El problema
Las encuestas dan porcentajes. El Parlamento de Andalucía reparte escaños.
109 escaños, repartidos en 8 circunscripciones provinciales
Cada provincia aplica D’Hondt con barrera del 3%
Un mismo % regional puede dar mayorías muy distintas según cómo se reparta por provincia
La pregunta real no es “¿qué % saca el PP?”, es “¿qué probabilidad tiene cada reparto posible de escaños?”
Por qué no basta un número
“El PP rozará la mayoría absoluta”
Un titular así esconde una distribución entera de escenarios posibles.
Con un enfoque bayesiano no perseguimos el número que más se acerque, perseguimos la distribución de plausibilidad completa — y con ella, la probabilidad de cada mayoría.
El flujo en una imagen
Encuestas (23, distintas empresas)
⬇
Meta-análisis bayesiano → posterior regional
⬇ + error histórico de las encuestas
Posterior ajustado
⬇ + reparto provincial (Dirichlet)
Posterior provincial
⬇ D’Hondt, provincia a provincia
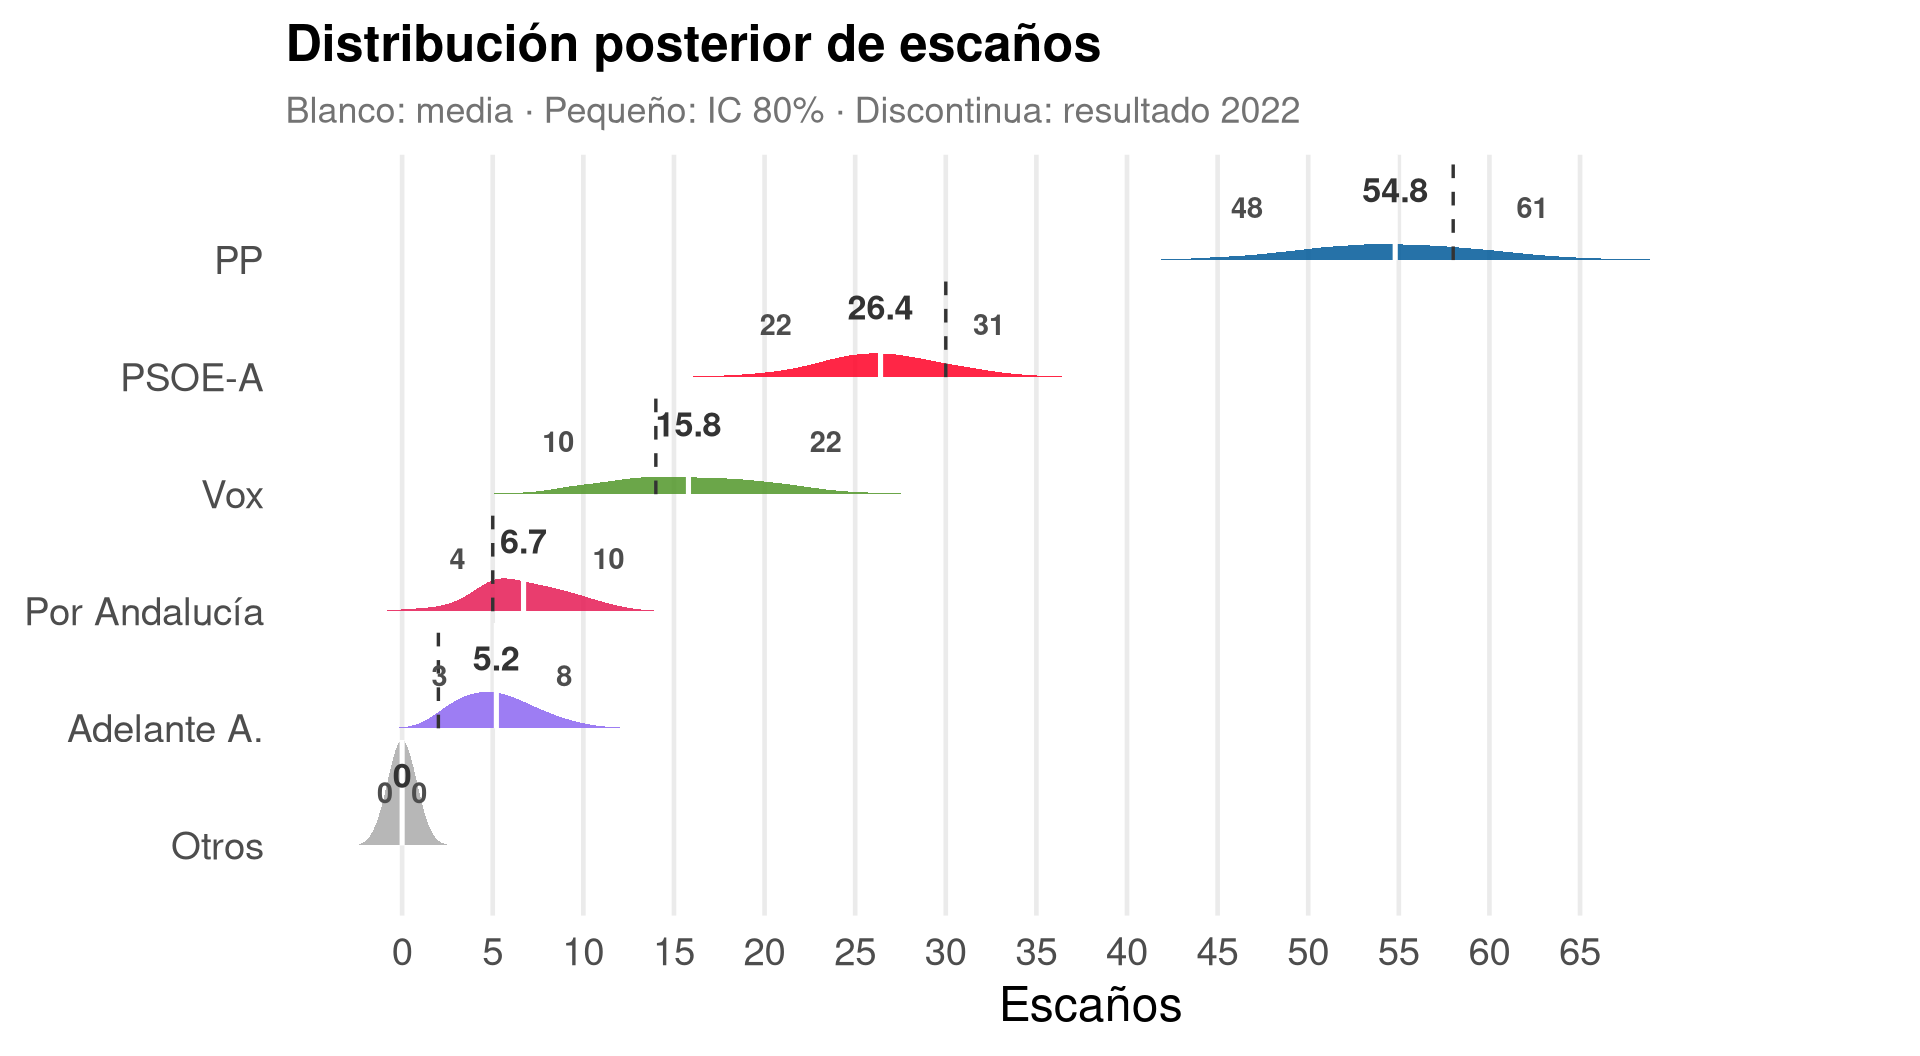
Distribución posterior de escaños
Los datos
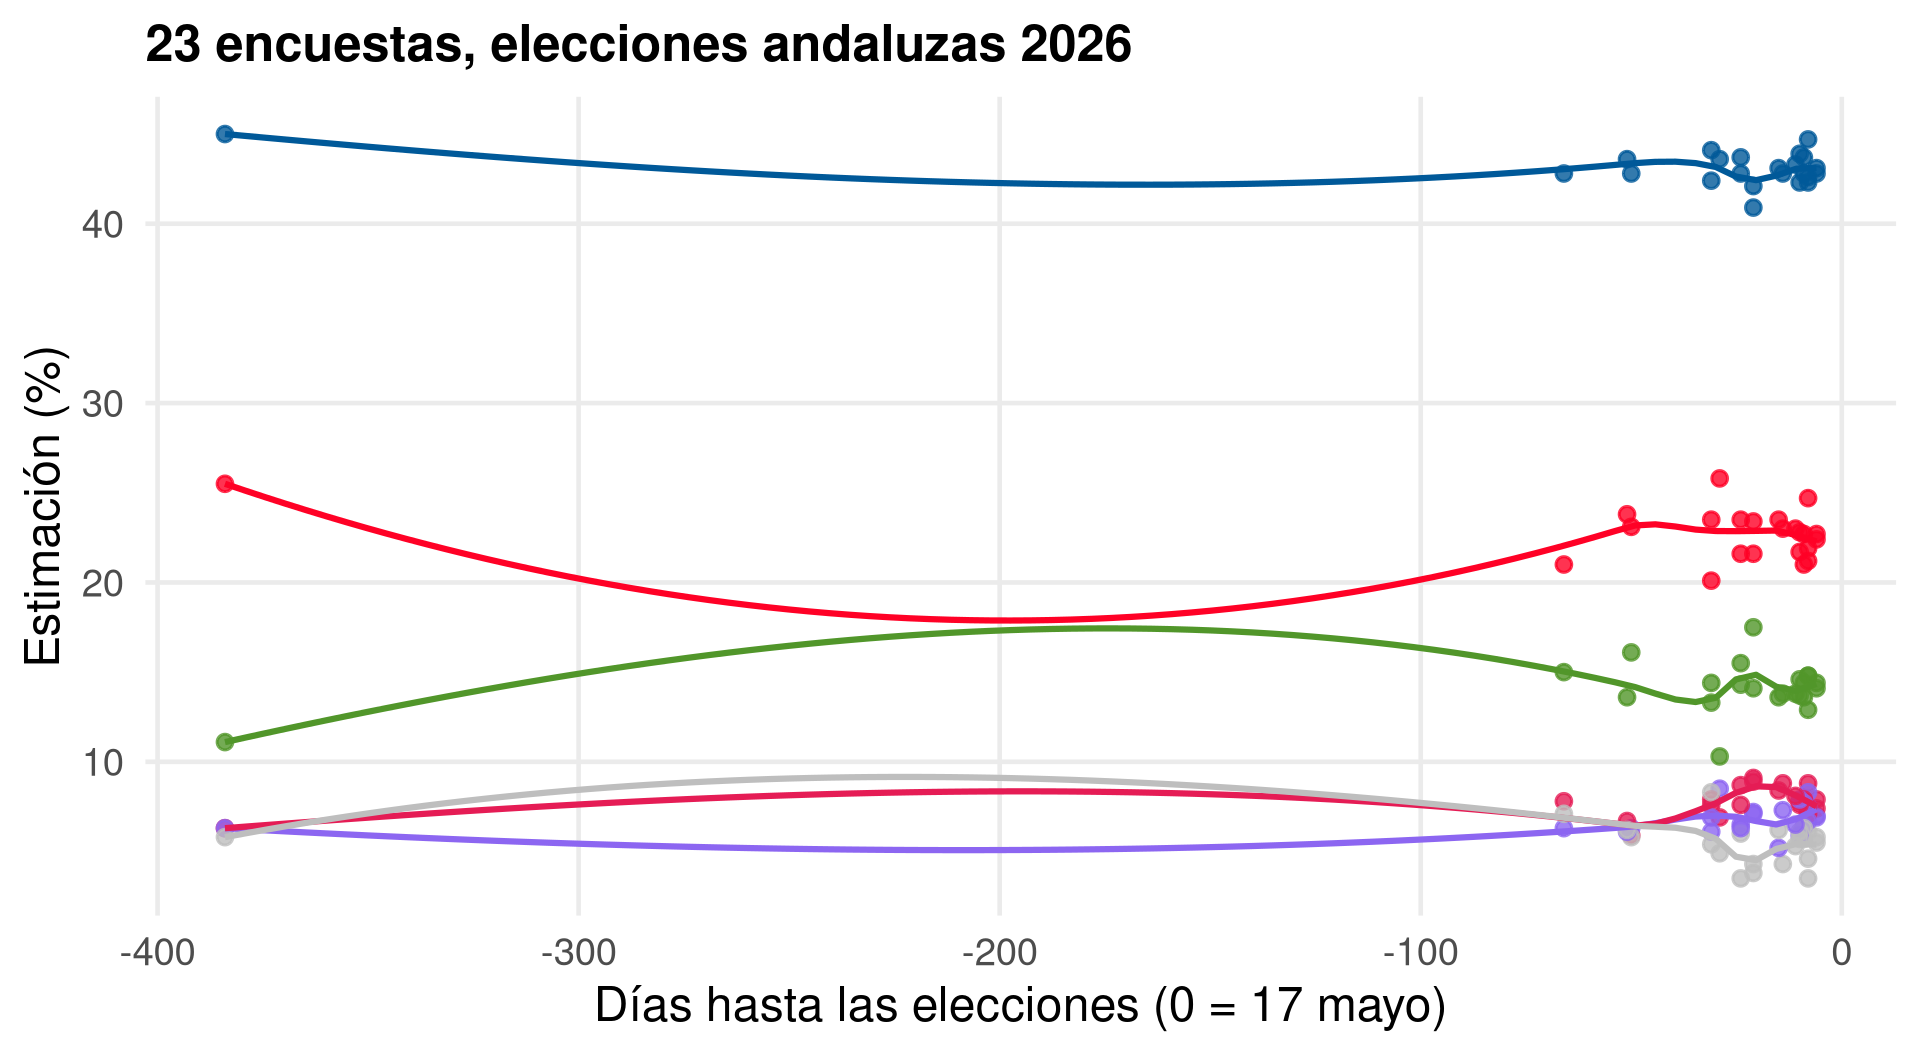
23 encuestas publicadas entre marzo y mayo de 2026
Fuente: tabla de sondeos de Wikipedia (EN)
Solo encuestas con tamaño muestral publicado
Columna resto: complemento a 100 de los 5 partidos principales
Figura 1
El modelo
Modelo multinomial bayesiano con brms: cada encuesta aporta un vector de votos por partido.
formula <-brmsformula( cell_counts |trials(n) ~ time + (time | empresa))brm(formula, df_wider, family =multinomial(),iter =4000, warmup =1000, chains =4,control =list(adapt_delta =0.95))
cell_counts | trials(n): composición multinomial (los 6 partidos suman n)
(time | empresa): cada casa encuestadora tiene su propio intercepto y tendencia
time: días hasta las elecciones, recoge la evolución temporal
Prior predictive check
(Opcional — solo si sobra tiempo)
Los priors por defecto de brms en multinomial son impropios (flat): no se puede muestrear solo del prior. Sustituimos por priors propios, débilmente informativos en escala log-odds.
priors_ppc <- priors |>mutate(prior =case_when( prior !=""~ prior, class =="b"~"normal(0, 2)", class =="Intercept"~"normal(0, 2)", class =="sd"~"exponential(1)",TRUE~ prior ))
Normal(0, 2) en log-odds cubre de sobra el rango 0-100% de voto; Exponential(1) restringe las desviaciones a positivas con cola moderada.
Diagnósticos
(Opcional — solo si sobra tiempo)
Tabla 1
param
Estimate
Rhat
Bulk_ESS
mupsoe_Intercept
-0.650
1.000
9259.035
muvox_Intercept
-1.116
1.001
8889.662
muporandalucia_Intercept
-1.658
1.000
9144.901
muadelante_Intercept
-1.788
1.000
9805.963
muresto_Intercept
-2.066
1.001
3704.953
19 de 12000 transiciones divergentes (0.15%) — el resto de diagnósticos (interceptos por partido; las pendientes _time son igual de limpias), Rhat ≈ 1, ESS > 3700.
Efectos por empresa
(Opcional — solo si sobra tiempo)
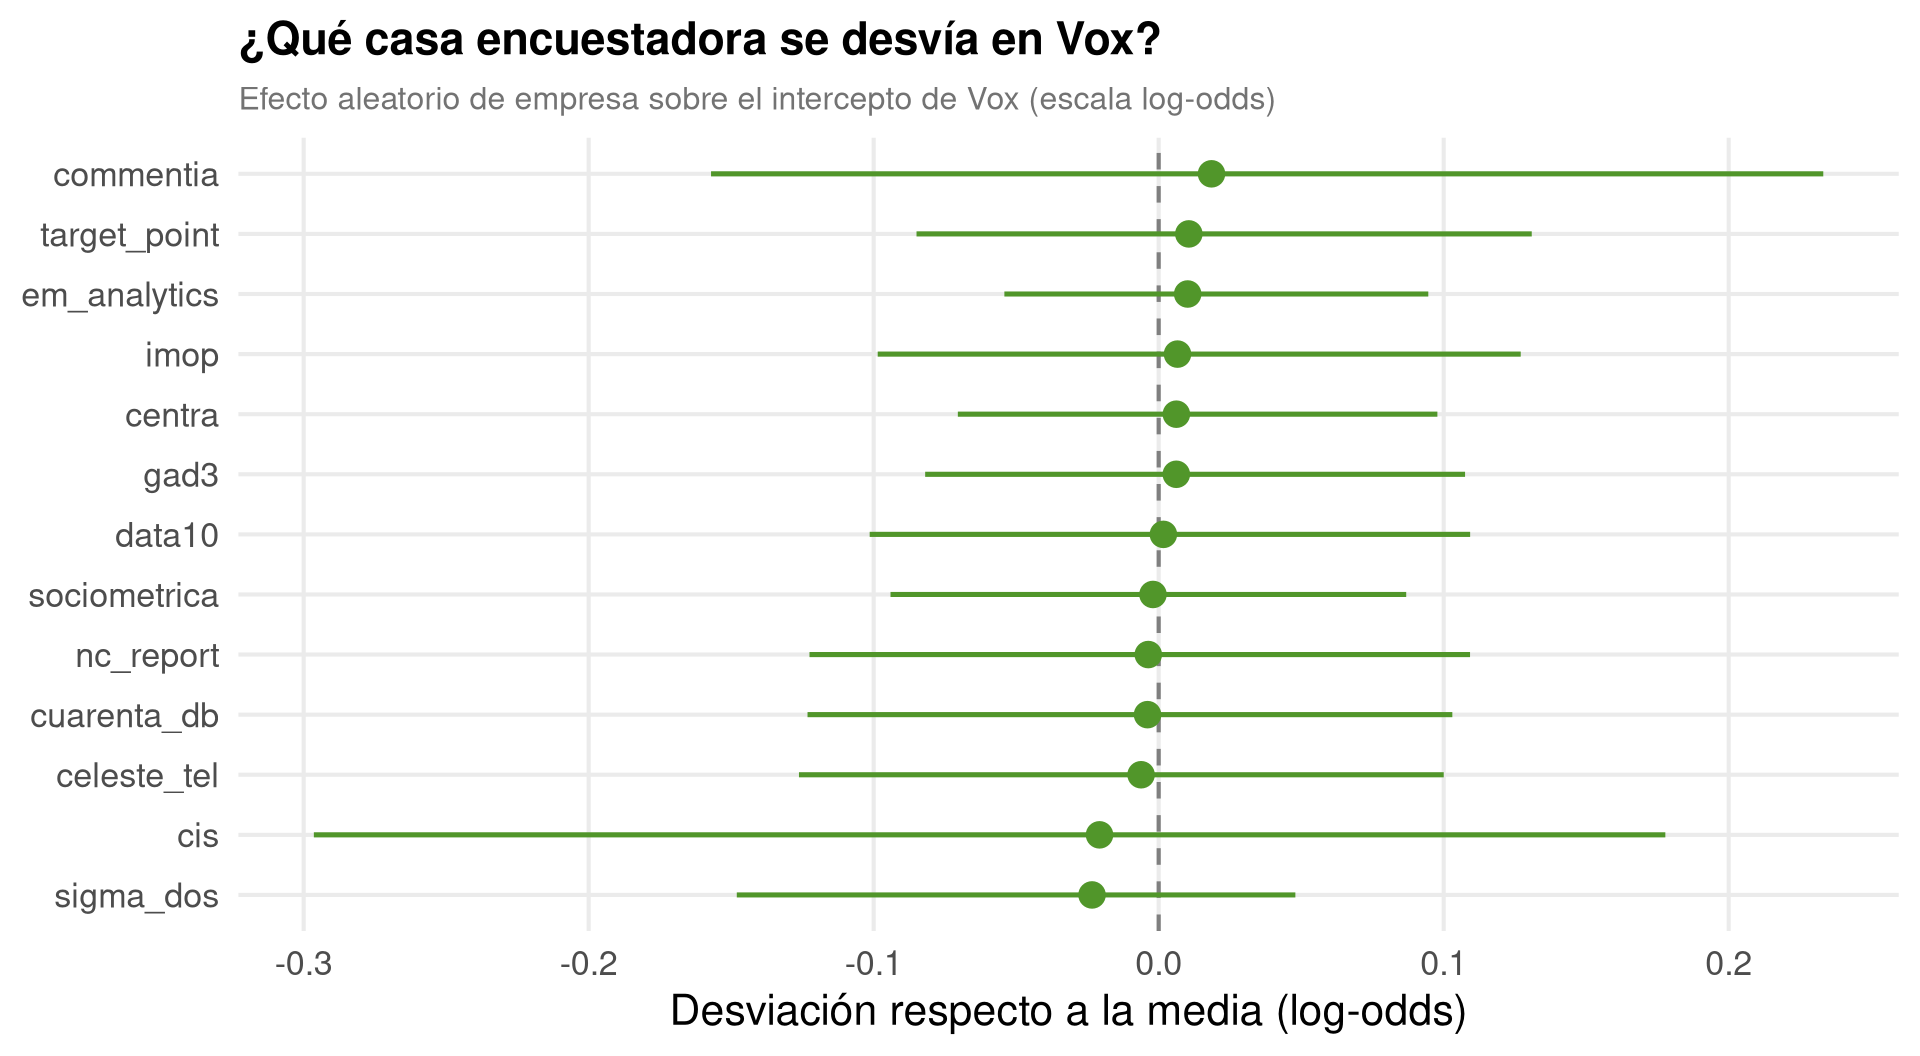
¿Qué casa encuestadora se desvía sistemáticamente, y hacia dónde?
¿Funciona?
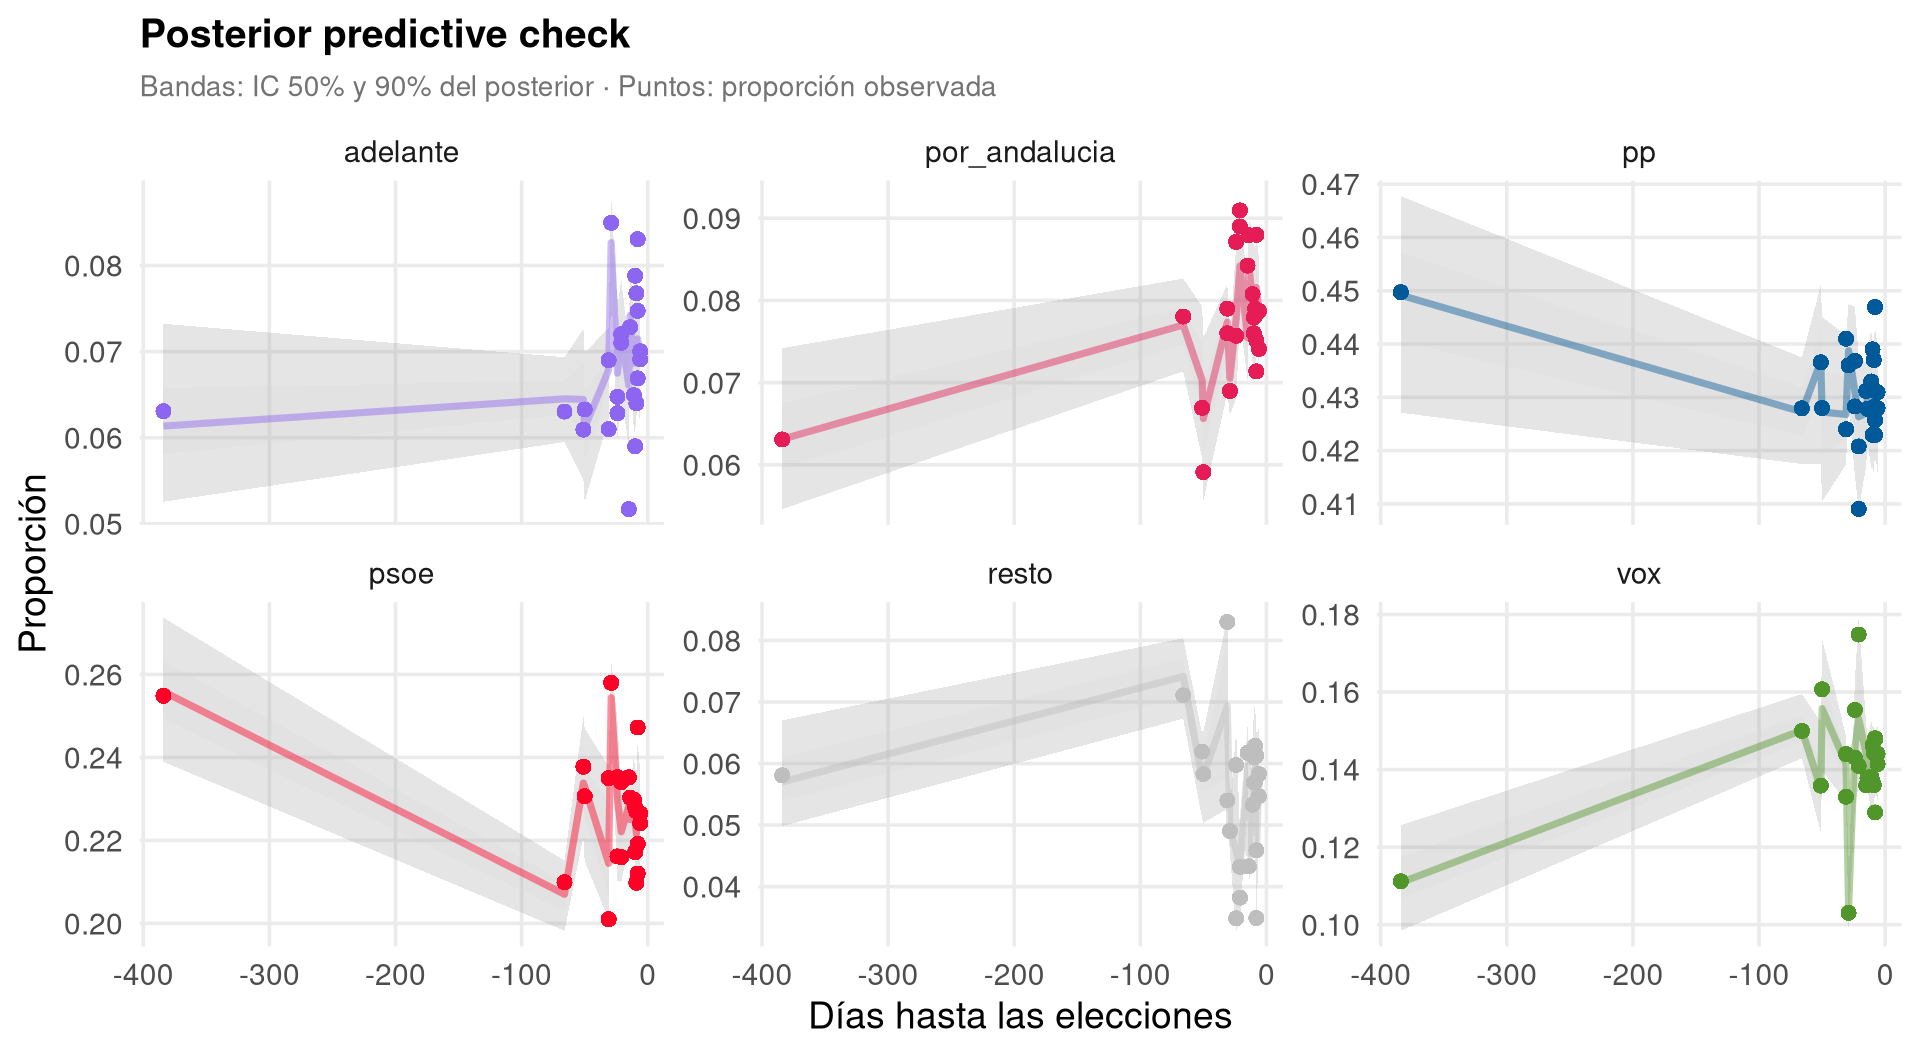
pp_check() no está implementado para la familia multinomial: lo hacemos a mano, comparando proporciones predichas vs. observadas por encuesta.
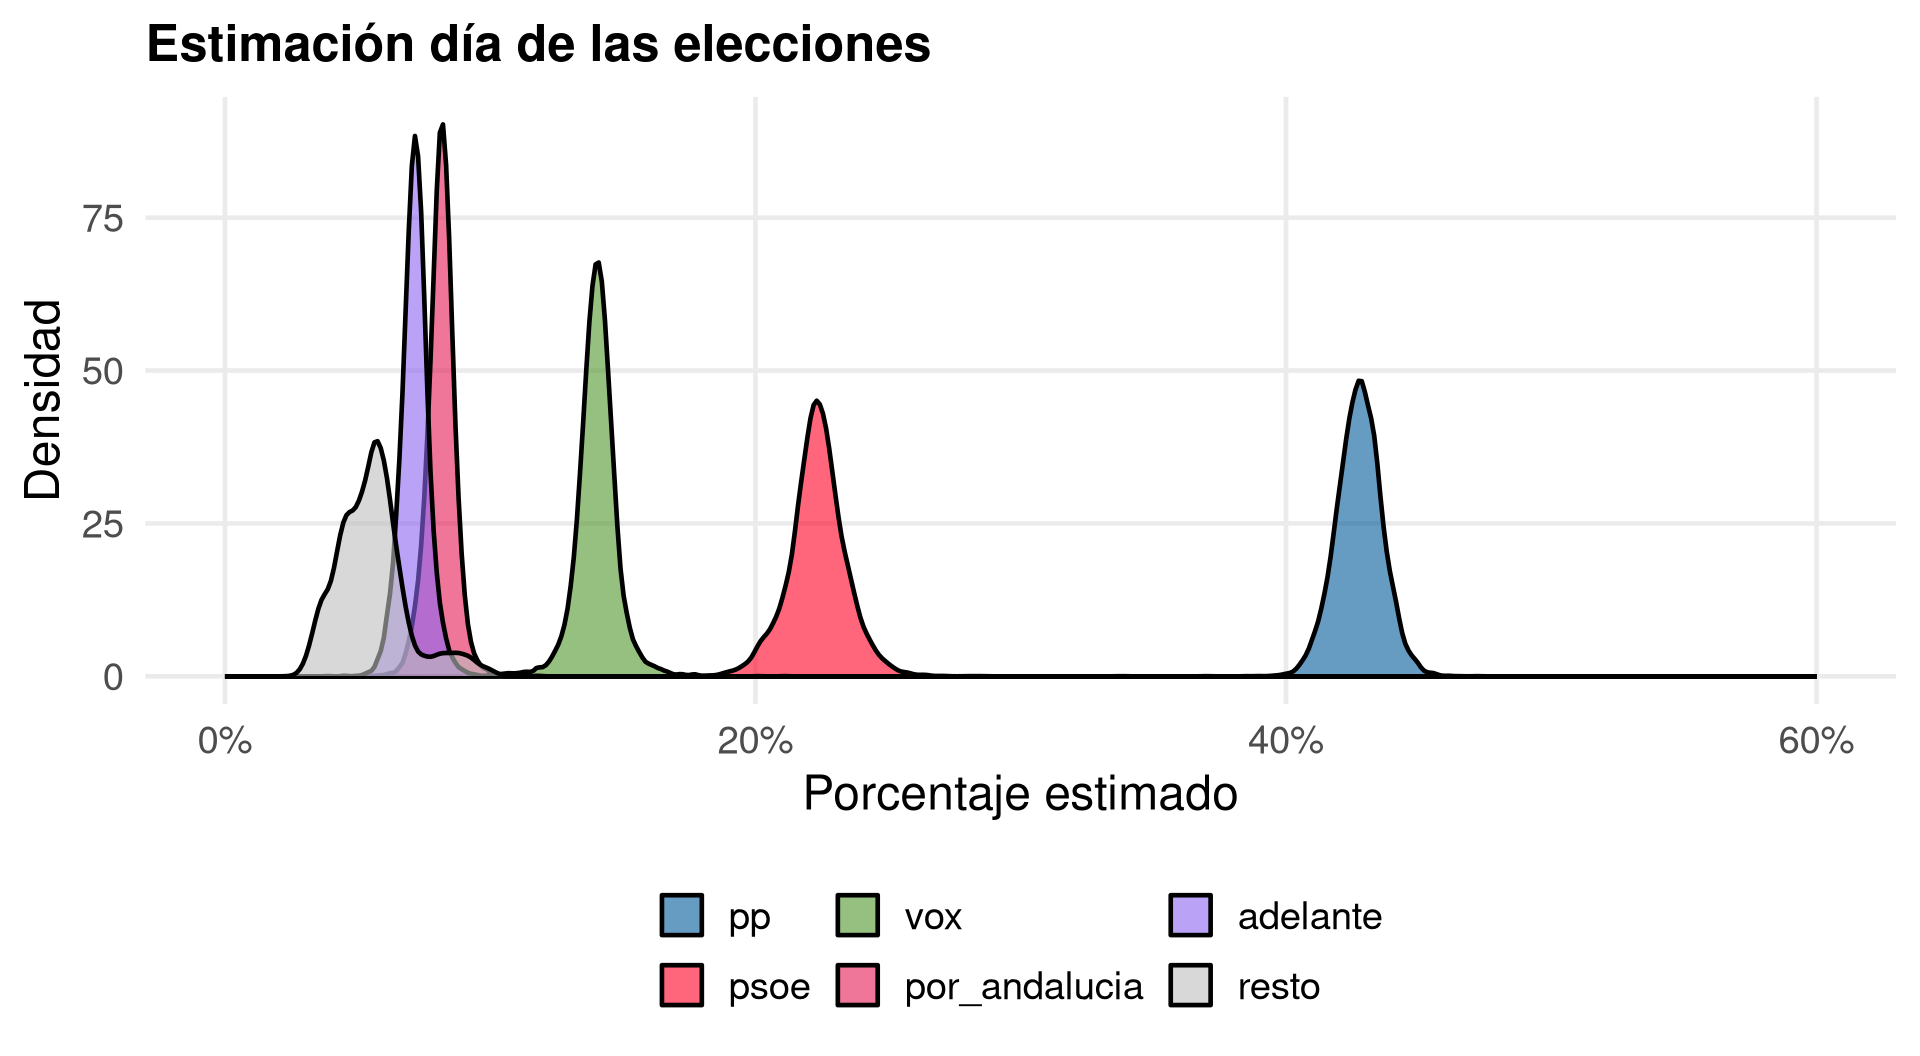
Posterior día D
Tratamos las elecciones como una “nueva encuesta” con time = 0 y empresa desconocida.
Tabla 2
Partido
Media
IC 90%
pp
42.8
41.3–44.2
psoe
22.3
20.5–24.1
vox
14.0
12.9–15.2
por_andalucia
8.2
7.3–8.9
adelante
7.2
6.3–8.0
resto
5.6
3.6–8.4
Aquí acaba la mayoría de agregadores…
…y aquí empieza lo interesante.
Tres fuentes de incertidumbre
El modelo bayesiano de encuestas — ¿cuánto voto tiene realmente cada partido a nivel andaluz?
Error histórico de las encuestas — se equivocan, y de forma correlada entre partidos
Reparto provincial — las encuestas no dan (fiablemente) datos por provincia, hay que asumir algo
El error histórico
Cuando se sobreestima al PP normalmente se infraestima a Vox (trasvase de voto útil): ρ(PP, Vox) ≈ −0.5.
El bloque de izquierda falla o acierta en bloque: ρ(PSOE, Por Andalucía) ≈ +0.5.
Matriz de correlación fijada a criterio experto — con solo 2-3 elecciones con datos completos (2022, 2018) no hay muestra suficiente para estimarla.
En código
Añadimos al posterior un error extraído de una normal multivariante con esa matriz de correlación:
error_draws <- MASS::mvrnorm( n_draws, mu =rep(0, 6), Sigma = Sigma_prop)draw_adj <-pmax(draws_mat + error_draws, 0) # sin proporciones negativasdraw_adj <- draw_adj /rowSums(draw_adj) # cada fila vuelve a sumar 1
El reparto provincial
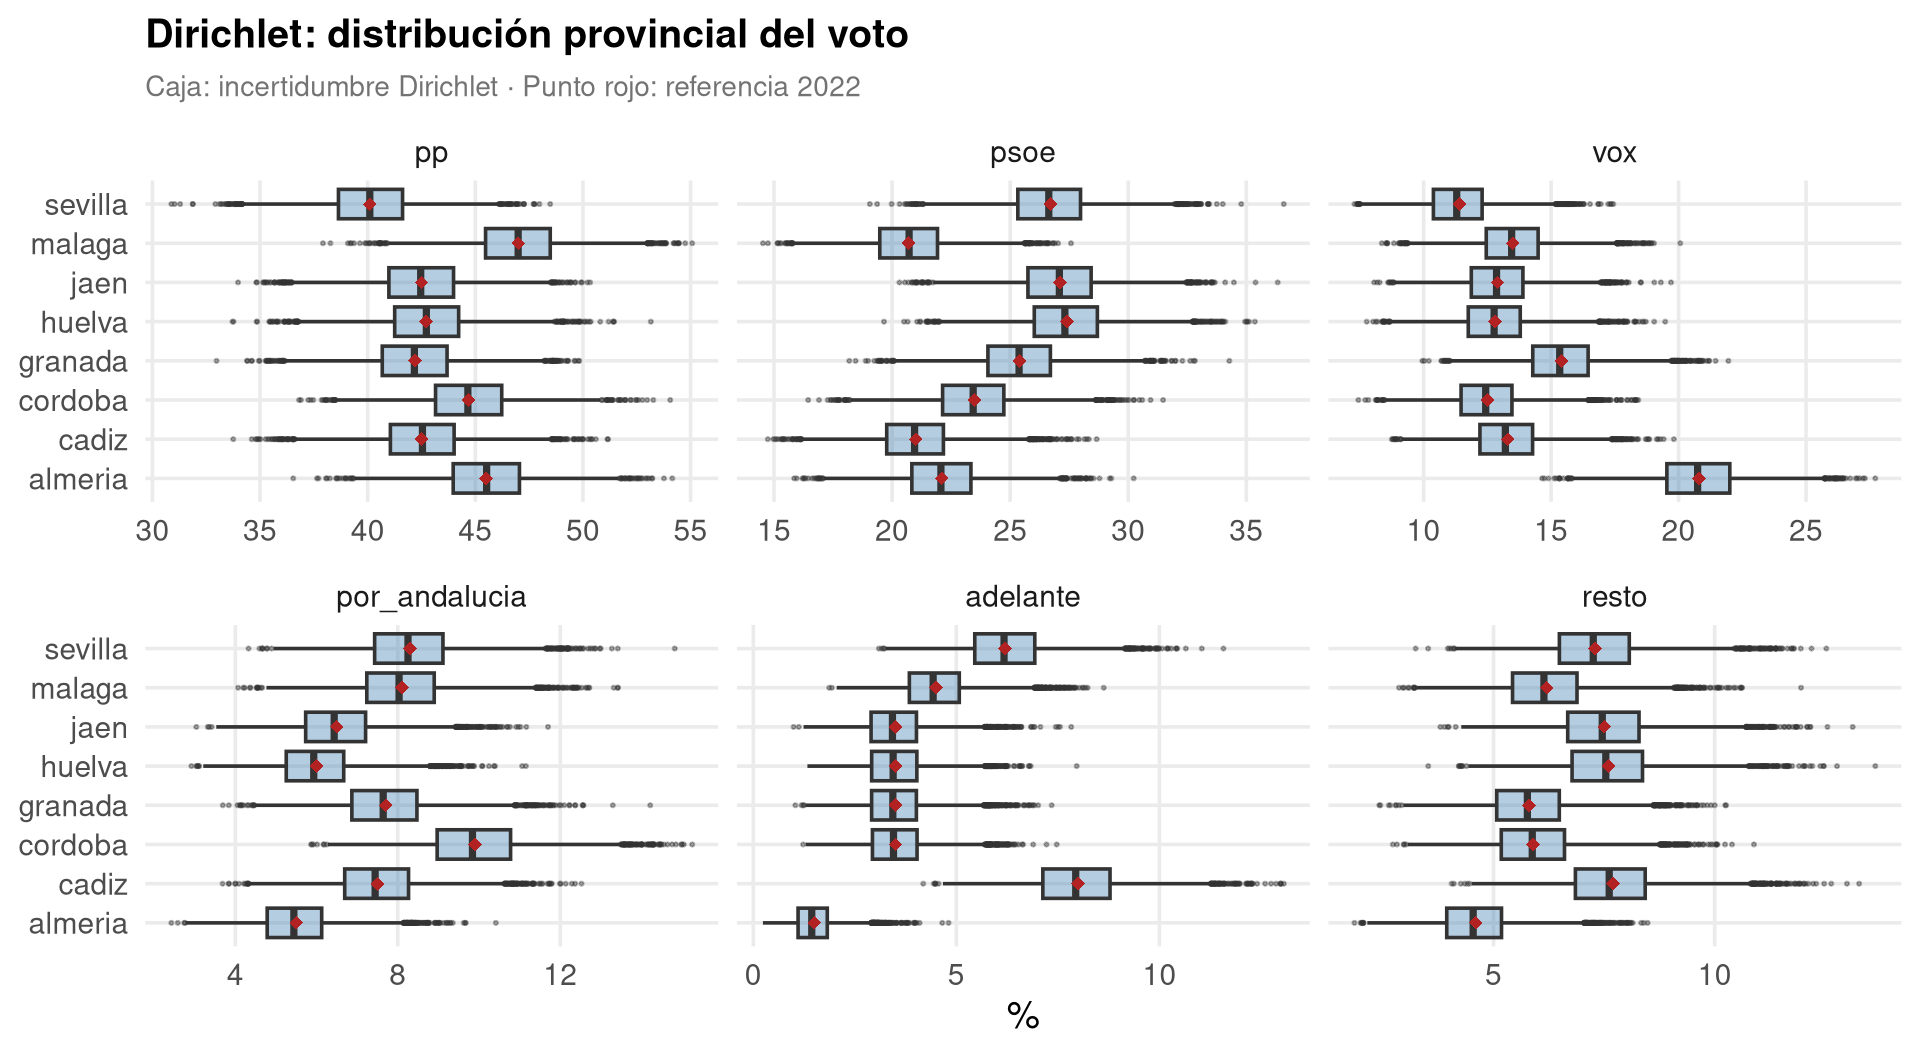
Las encuestas dan % regional. D’Hondt se aplica por provincia. Hipótesis de trabajo: el reparto territorial de 2026 se parece al de 2022.
Ejemplo — Almería: Vox sacó allí el doble que su media regional en 2022. Asumimos que ese diferencial se mantiene, pero lo perturbamos con incertidumbre.
% provincia = % regional × (ratio provincia 2022 / media regional 2022)
perturbado con una Dirichlet
sim_escanos_draw() paso a paso
(Opcional — solo si sobra tiempo) · Ejemplo de juguete: 2 partidos, 2 provincias.
draw_vec <-c(A =0.52, B =0.48) # posterior regionalregional_2022 <-c(A =50, B =50) # referencia regionalprov_2022 <-c(A =60, B =40) # Norte 2022: A ganóratio <- (prov_2022 /100) / (regional_2022 /100)raw <- draw_vec * rationorm <- raw /sum(raw)round(norm, 3)
    A     B
0.619 0.381
En Norte, A pasa de 52% regional a 61.9% provincial: el ratio 2022 (60/50) amplifica el resultado regional en su feudo.
Coste computacional
(Opcional — solo si sobra tiempo)
12000 draws × 8 provincias = 96000 repartos D’Hondt.
Cociente votos / (escaños_ya_asignados + 1): el partido con el cociente más alto se lleva el escaño, ronda a ronda.
Resultado: escaños
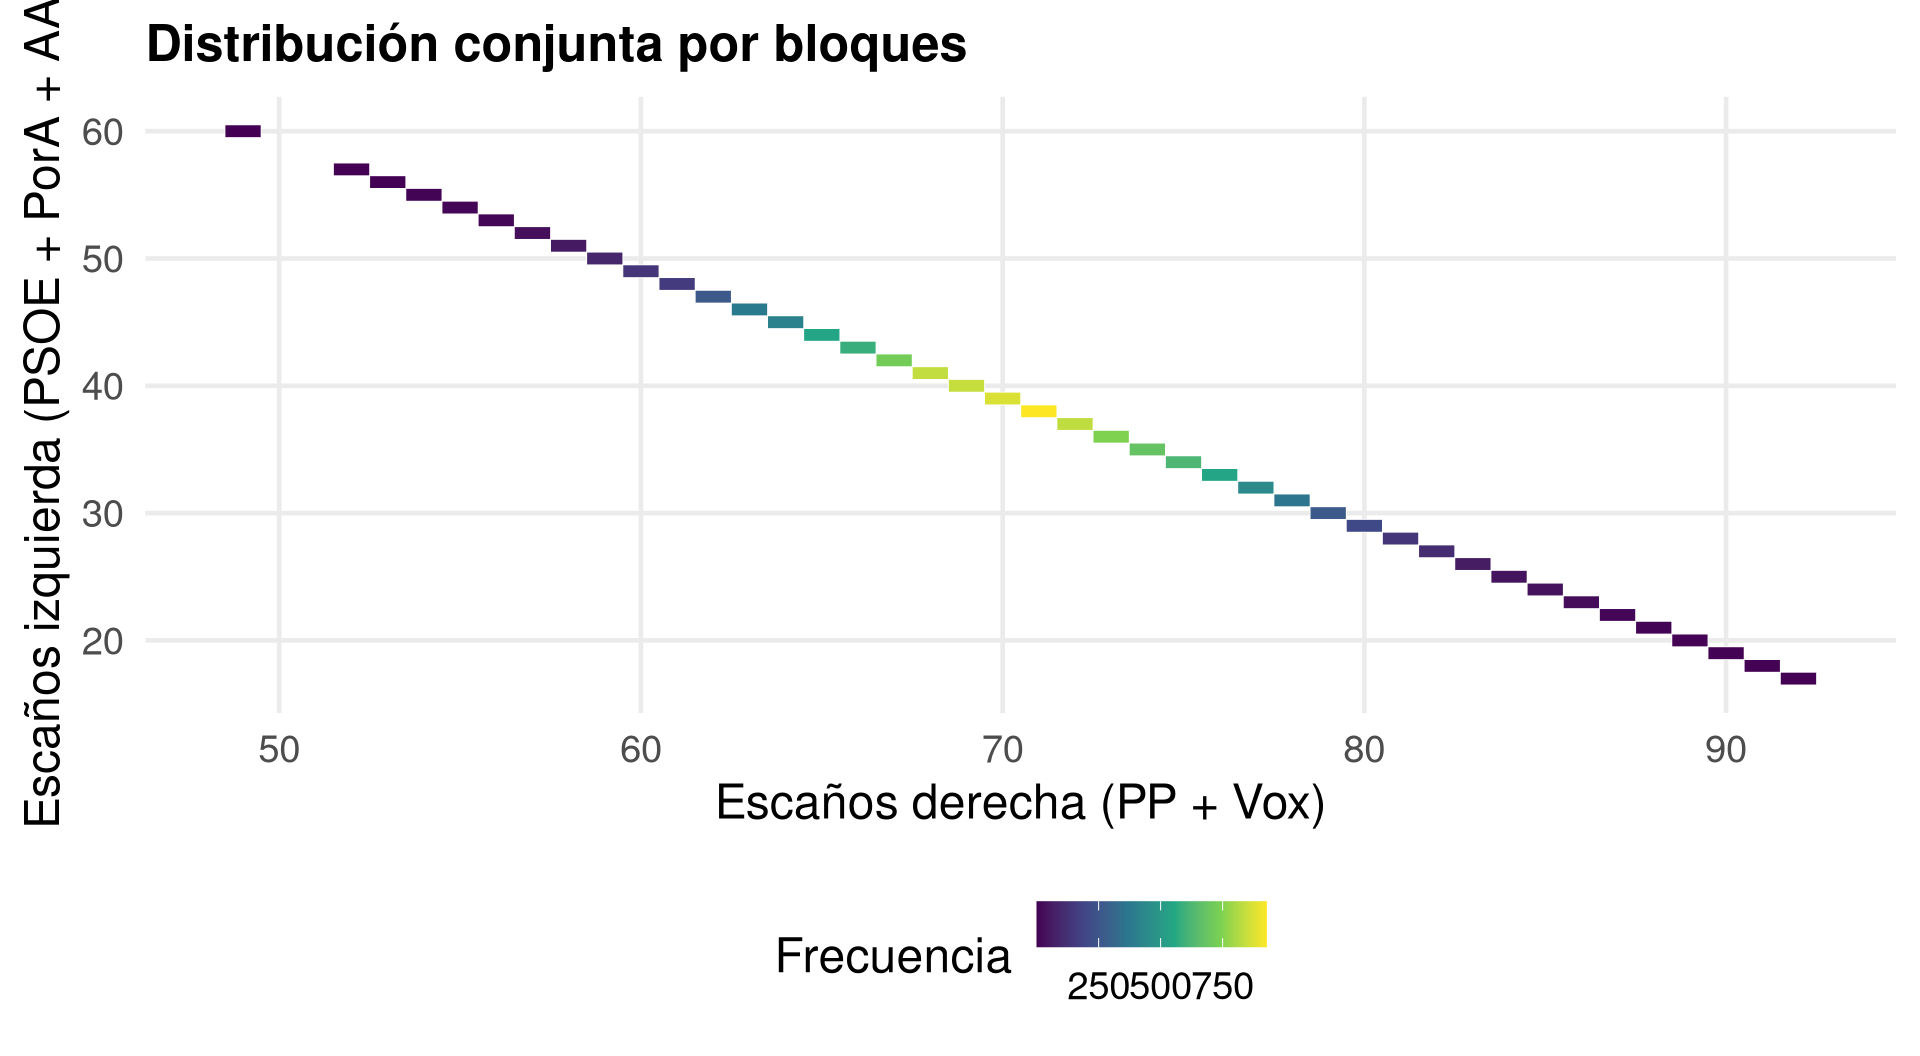
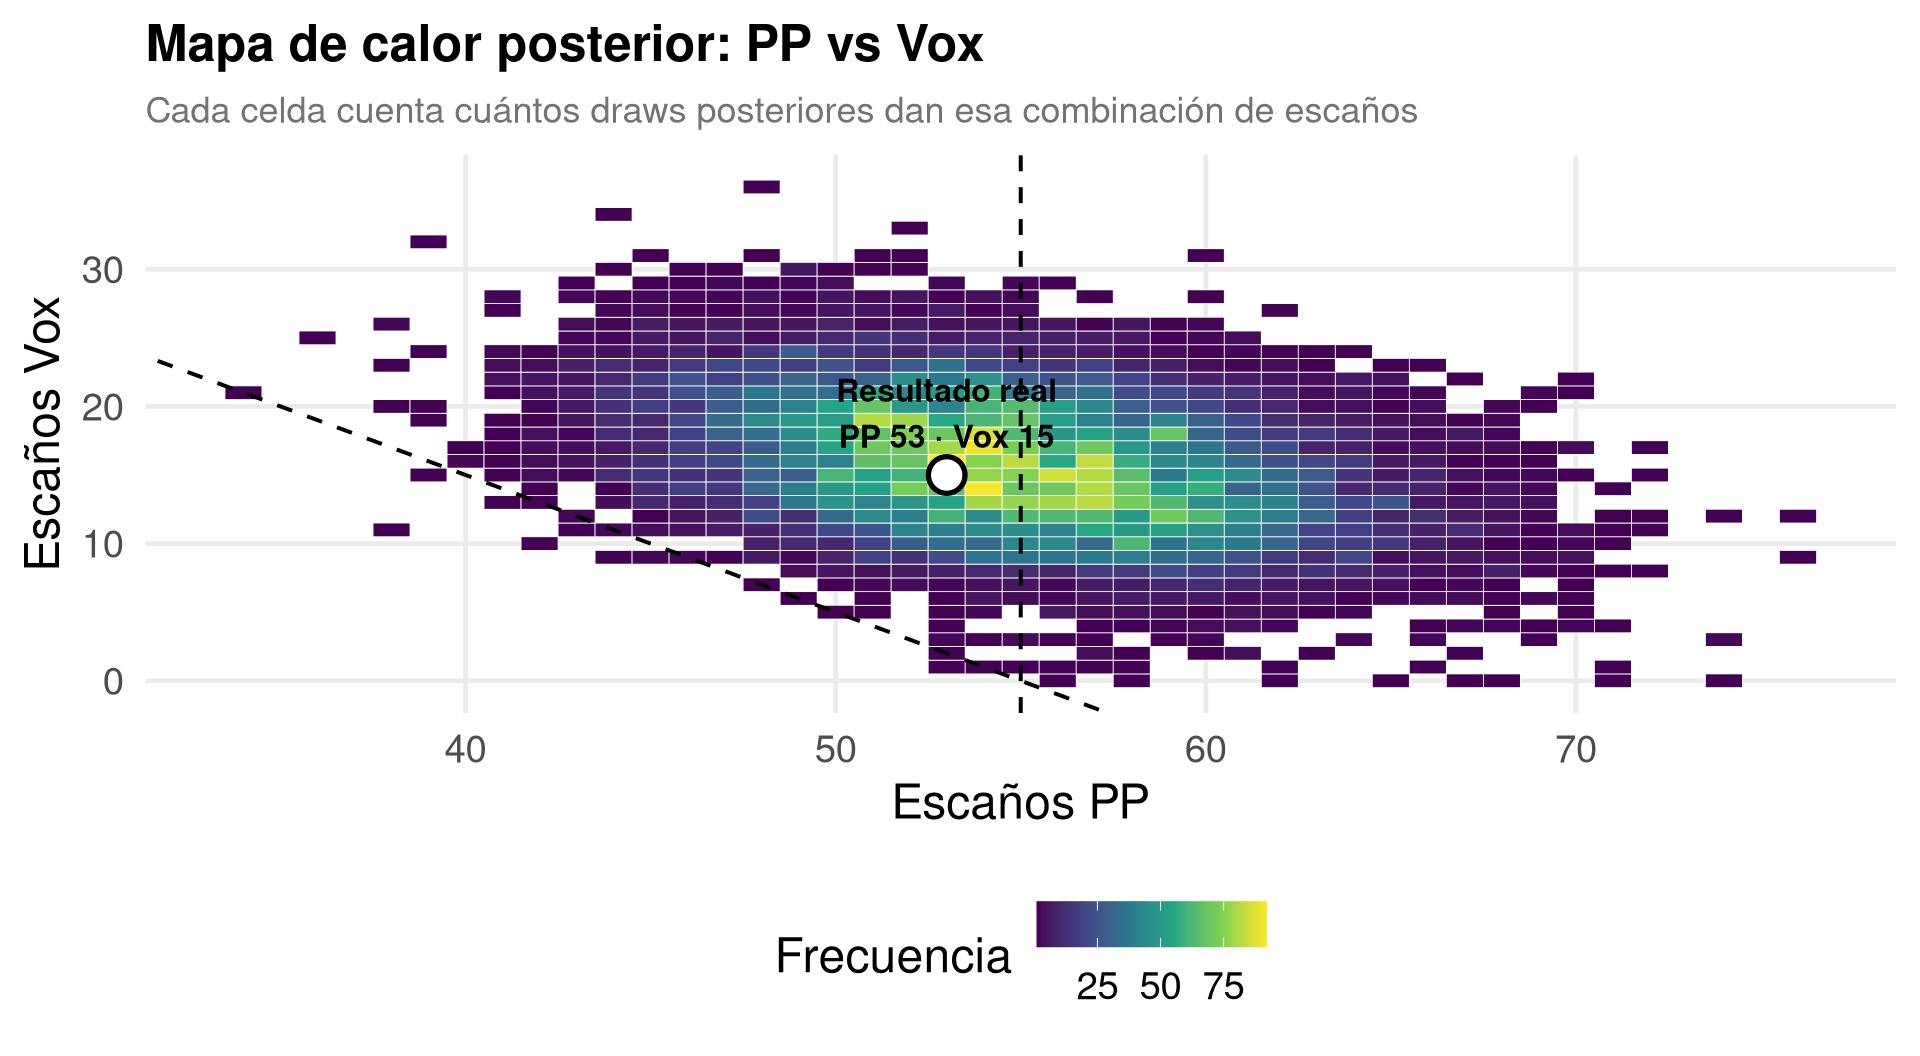
Distribución conjunta por bloques
(Opcional — solo si sobra tiempo)
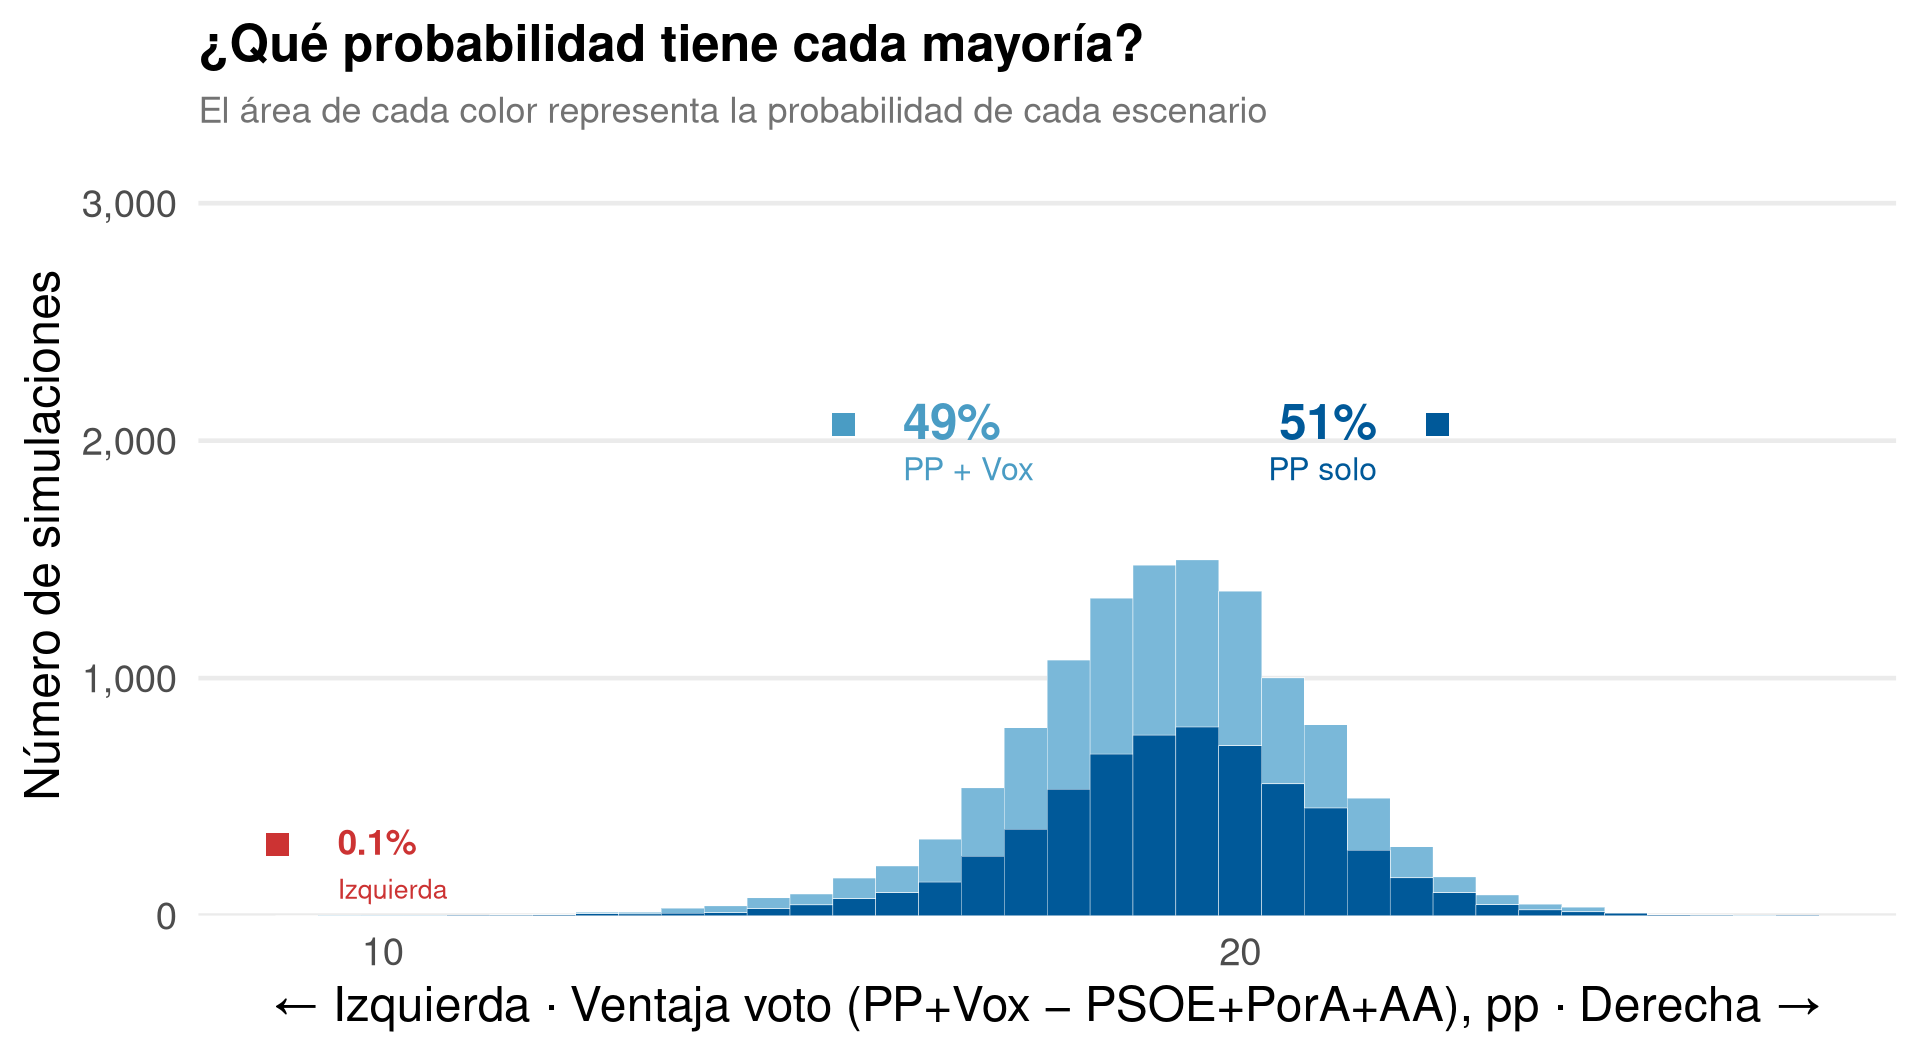
¿Qué mayoría?
¿Adelante por delante de Por Andalucía?
(Opcional — solo si sobra tiempo)
Las encuestas daban a Por Andalucía por delante. Pero la incertidumbre provincial deja una probabilidad nada desdeñable de sorpaso:
P(Adelante > Por Andalucía) = 24.0%
Validación 17-M
No acerté el número exacto — acerté la región de plausibilidad.
Limitaciones y cierre
Según Virgilio Gómez Rubio: lo correcto sería meter todas las fuentes de incertidumbre en un único modelo bayesiano, y sumar el error histórico en escala logit en vez de aditivamente en proporciones.
Hipótesis fuerte: el reparto provincial de 2026 se parece al de 2022
Matriz de correlación del error histórico, fijada a criterio experto
No sabemos qué hipótesis de abstención usa cada encuestadora